NVIDIA RTX 30 Ekran Kartlarında Yapay Zeka Performansını Uçuran Yeni Araç: Yüzde 80’e Varan Artış
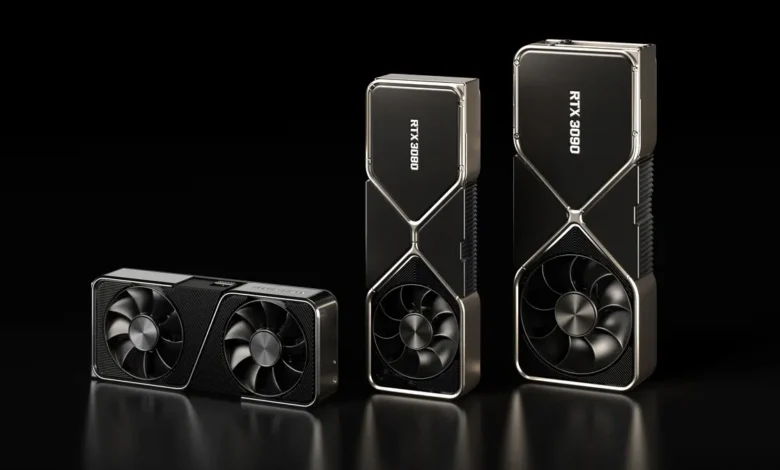
NVIDIA’nın GeForce RTX 30 serisi ekran kartları, yıllar sonra yapay zeka tarafında yeniden gündeme oturdu. Zagitta tarafından geliştirilen açık kaynaklı GPU-Unlock aracı, bazı Ampere tabanlı GeForce modellerinde FP16 ve BF16 hesaplama hızına uygulanan sınırlamaları kaldırarak özellikle yapay zeka ve büyük dil modeli (LLM) iş yüklerinde dikkat çekici performans artışları sağlayabiliyor.
Yayınlanan test sonuçlarında bazı RTX 30 modellerinin belirli matris hesaplamalarında yüzde 70-80 seviyesine varan performans kazanımları elde ettiği görülüyor. Gerçek LLM kullanımında ise kazanç, kullanılan model ve iş yükünün hesaplama ya da bellek bant genişliği ağırlıklı olmasına göre ciddi ölçüde değişiyor.
GPU-Unlock tam olarak ne yapıyor?
Zagitta’nın GitHub üzerinden yayımladığı GPU-Unlock, klasik anlamda bir ekran kartı BIOS modu değil. Kullanıcının ekran kartına değiştirilmiş bir vBIOS yüklemesi veya NVIDIA sürücüsünü manuel olarak yamalaması gerekmiyor.
Proje, Linux açılışı sırasında NVIDIA sürücüsü ekran kartını devralmadan önce çalışan bir Linux kernel modülü kullanıyor. Modül, GPU üzerindeki bazı hız seçicilerini değiştirerek FP16 ve BF16 işlemlerinin komut yürütme hızını profesyonel GPU’lardaki seviyeye yaklaştırmayı amaçlıyor.
Geliştiricinin açıklamasına göre yöntem özellikle Ampere mimarisindeki bazı GPU’larda FP/BF16 FMA işlemlerinin yürütme hızını teorik olarak iki kata kadar çıkarabiliyor.
Bu noktada önemli bir ayrıntı var: “iki kat hesaplama kapasitesi” ifadesi doğrudan her uygulamanın iki kat hızlı çalışacağı anlamına gelmiyor.
Ekran kartının güç limiti, saat hızları, VRAM bant genişliği, kullanılan model, hesaplama hassasiyeti ve yazılım altyapısı gerçek performans artışını doğrudan etkiliyor.
RTX 3090 Ti’da BF16 performansı 157 TFLOPS’a çıktı
Projenin paylaştığı en dikkat çekici testlerden biri GeForce RTX 3090 Ti üzerinde gerçekleştirildi.
8192³ büyüklüğündeki yoğun GEMM testinde ve FP32 accumulation kullanıldığında ölçülen sonuçlar şöyle:
| İşlem türü | Standart | GPU-Unlock sonrası |
|---|---|---|
| FP16 | 87,46 TFLOPS | 118,39 TFLOPS |
| BF16 | 87,50 TFLOPS | 157,41 TFLOPS |
| TF32 | 42,58 TFLOPS | 82,61 TFLOPS |
Özellikle BF16 tarafındaki artış oldukça çarpıcı. Performans yaklaşık yüzde 80 yükselerek 157 TFLOPS seviyesine ulaşıyor.
TF32 performansı da neredeyse iki katına çıkıyor. Ancak FP16 tarafındaki gerçek kazanım daha düşük kalıyor. Bunun önemli nedenlerinden biri ekran kartının güç ve saat frekansı sınırları.
RTX 3080’de yüzde 70’i aşan performans artışı görüldü
RTX 3080 10 GB üzerinde yapılan bağımsız topluluk testleri de aracın yalnızca RTX 3090 ailesine özel olmadığını gösteriyor.
PyTorch kullanılarak gerçekleştirilen testlerde:
FP16 performansı 61,82 TFLOPS’tan 112,61 TFLOPS’a,
BF16 performansı 66,37 TFLOPS’tan 113,08 TFLOPS’a,
TF32 performansı ise 32,55 TFLOPS’tan 54,55 TFLOPS’a çıktı.
Bu değerler sırasıyla yaklaşık yüzde 82, yüzde 70 ve yüzde 68 performans artışına karşılık geliyor. Aynı testte klasik FP32 ve INT8 performansının ise neredeyse değişmediği görülüyor.
Bu durum GPU-Unlock’ın tüm GPU’yu genel anlamda hızlandırmadığını, daha çok belirli Tensor Core / FP16-BF16 hesaplama yollarındaki sınırlamayı hedeflediğini gösteriyor.
RTX 3070 ve RTX 3060 da çalışıyor
Topluluk testleri daha düşük seviyedeki Ampere kartlarda da olumlu sonuçlar ortaya koyuyor.
RTX 3070 üzerinde yapılan testlerde FP16 ve BF16 performansının yaklaşık 39 TFLOPS seviyesinden 68-73 TFLOPS aralığına çıkabildiği rapor edildi. RTX 3070 testlerinden birinde sistemin ağır yapay zeka iş yükleri altında da kararlı biçimde çalıştığı belirtildi.
RTX 3060 tarafında da 24 Ekim 2026 tarihinde yayımlanan bir kullanıcı raporunda dört adet RTX 3060 12 GB kartla çalışan Qwen tabanlı bir modelde prefill performansının 450’den 600’e yükseldiği, ancak token üretim hızının neredeyse değişmediği bildirildi.
Bu sonuç, GPU-Unlock’ın LLM performansına etkisini anlamak açısından oldukça önemli.
Amazon’da RTX 30xx fiyatlarını inceleyebilirsiniz →
LLM’lerde neden her şey iki kat hızlanmıyor?
Büyük dil modellerinin çalışması temel olarak iki farklı aşamada değerlendirilebilir: prefill ve decode.
Prefill aşamasında modele verilen uzun metnin ilk kez işlenmesi sırasında yoğun matris hesaplamaları gerçekleştiriliyor. Dolayısıyla Tensor Core hesaplama gücünün yükselmesi burada ciddi avantaj sağlayabiliyor.
Decode aşamasında, yani model kelime veya token üretmeye başladığında ise performans çoğu senaryoda GPU’nun ham hesaplama gücünden çok VRAM bant genişliğiyle sınırlanıyor.
Bu nedenle RTX 3080 20 GB kartlarla yapılan bir LLM testinde vLLM tabanlı iş yükünde prefill performansı yüzde 33-36 artarken, ilk token’a ulaşma süresi yaklaşık yüzde 25-26 azaldı. Buna karşılık decode performansında kayda değer bir değişiklik görülmedi.
Benzer şekilde dört RTX 3090 kullanılan başka bir testte prefill performansı yaklaşık yüzde 9 artarken decode tarafı ölçüm hatası sınırları içinde kaldı. Aynı kullanıcı, LoRA fine-tuning işleminde ise yaklaşık yüzde 20-24 gerçek çalışma süresi avantajı bildirdi.
Dolayısıyla GPU-Unlock özellikle model eğitimi, fine-tuning, uzun prompt işleme ve hesaplama yoğun yapay zeka işlerinde daha anlamlı sonuçlar verebilir.
Güç tüketimi performansı doğrudan etkiliyor
Ortaya çıkan bir başka önemli detay da güç limiti.
GPU-Unlock sonrasında ekran kartı aynı zaman diliminde daha fazla matematiksel işlem yapabildiği için güç sınırına daha hızlı ulaşabiliyor. Bunun sonucunda GPU saat hızları düşebiliyor.
RTX 3090 üzerinde gerçekleştirilen bağımsız bir testte FP16 ve BF16 performansının saat frekansı başına yaklaşık iki kat arttığı, ancak kartın 350 watt güç sınırına ulaşması nedeniyle gerçek toplam performans artışının yaklaşık yüzde 57-60 seviyesinde kaldığı görüldü.
Bu nedenle teorik olarak 2 kat komut yürütme kapasitesi, pratikte her zaman yüzde 100 performans artışı anlamına gelmiyor.
Her RTX 30 modeli aynı sonucu vermiyor
Aracın henüz yeni olması nedeniyle uyumluluk tarafında dikkat edilmesi gereken noktalar bulunuyor.
Örneğin GA102-250 GPU kullanan bazı RTX 3080 Ti 20 GB OEM kartlarda modül başarıyla çalışmış görünmesine rağmen BF16 performansının yükselmediği rapor edildi.
RTX 3060 üzerinde de geliştirme sürecinde bazı firmware ve SEC2 erişim problemleri rapor edildi. Daha yeni kullanıcı testlerinde başarılı sonuçlar görülmeye başlansa da destek seviyesi karttan karta ve kullanılan Linux yapılandırmasına göre değişebiliyor.
Dolayısıyla GPU-Unlock şu aşamada sıradan kullanıcılar için “tek tıkla performans artırma aracı” olarak değerlendirilmemeli.
Şimdilik Linux gerekiyor
GPU-Unlock’ın mevcut sürümü Linux kernel modülü olarak çalışıyor.
Projenin kurulum sistemi Debian/Ubuntu, Arch tabanlı dağıtımlar ve Fedora/RHEL ailesi için paketleme seçenekleri içeriyor. Kernel modülünün, NVIDIA sürücüsü GPU’ya bağlanmadan önce initramfs aşamasında devreye girmesi gerekiyor.
Bu nedenle standart Windows kullanıcıları için doğrudan kullanılabilecek resmi bir Windows sürümü şu anda bulunmuyor.
Kurulum sürecinin kernel modülü, initramfs ve önyükleme parametreleri içermesi de deneyimsiz kullanıcıların dikkatli olması gerektiğini gösteriyor.
RTX 40 desteği konusunda temkinli olmak gerekiyor
İlk haberlerde aracın RTX 40 serisi ekran kartlarında da performans artışı sağladığı yönünde ifadeler yer alsa da projenin doğrulanmış testlerinin büyük bölümü Ampere mimarisine sahip RTX 30 serisi GPU’lara dayanıyor.
Güncel topluluk testleri RTX 3090 Ti, RTX 3090, RTX 3080, RTX 3070 ve RTX 3060 gibi modeller üzerinde yoğunlaşmış durumda. Bu nedenle RTX 40 serisinin tamamının aynı yöntemle hızlandırılabildiğini söylemek için henüz yeterli doğrulanmış veri bulunmuyor.
RTX 3090 neden yapay zeka kullanıcılarının gözdesi?
RTX 3090’ın yeniden ilgi görmesinin tek nedeni GPU-Unlock değil.
Kartta bulunan 24 GB GDDR6X VRAM, büyük yapay zeka modellerini yerel olarak çalıştırmak isteyen kullanıcılar için hâlâ oldukça değerli. Yeni nesil tüketici ekran kartlarında yüksek VRAM kapasitesinin pahalı modellere ayrılması, ikinci el RTX 3090’ları LLM topluluğu açısından cazip hale getiriyor.
GPU-Unlock gibi yöntemlerle FP16 ve BF16 hesaplama kapasitesinin daha verimli kullanılabilmesi de Ampere kartların yapay zeka sistemlerinde kullanım ömrünü uzatabilir.
Kaynak haberde RTX 3090 ve RTX 3090 Ti ikinci el fiyatlarının yapay zeka talebi nedeniyle çok hızlı yükseldiği ifade ediliyor. Ancak ikinci el ekran kartı fiyatları ülkeye, satıcıya ve kartın durumuna göre ciddi biçimde değiştiğinden bu tür rakamları genel piyasa fiyatı olarak değerlendirmek doğru olmaz.
Türkiye tarafında da özellikle 24 GB VRAM’e sahip RTX 3090 gibi modellerin ikinci el değeri; döviz kuru, stok durumu, kartın madencilik geçmişi ve yapay zeka amaçlı talep gibi faktörlere göre değişebiliyor.
Eski RTX 30 kartlar yapay zeka hızlandırıcısına dönüşüyor
Zagitta GPU-Unlock projesi, Ampere neslinin piyasaya çıkışından yıllar sonra RTX 30 serisi ekran kartlarının hâlâ ne kadar yüksek hesaplama potansiyeline sahip olduğunu gösteriyor.
Özellikle RTX 3090, RTX 3080, RTX 3070 ve RTX 3060 üzerinde ortaya çıkan test sonuçları oldukça dikkat çekici. Belirli FP16 ve BF16 matris işlemlerinde yüzde 70-80 seviyesinde kazanımlar görmek mümkün.
Ancak LLM tarafında sonuçların daha karmaşık olduğunu unutmamak gerekiyor. Prefill ve fine-tuning gibi hesaplama ağırlıklı işlemler ciddi biçimde hızlanabilirken, VRAM bant genişliğiyle sınırlanan token üretim aşamasında performans artışı çok daha düşük olabiliyor veya hiç görülmeyebiliyor.
Yine de 24 GB VRAM’e sahip RTX 3090 gibi kartların uygun yazılım optimizasyonlarıyla yerel yapay zeka sistemlerinde yeniden değer kazanması şaşırtıcı değil.
GPU-Unlock projesinin gelişimi devam ettikçe Ampere neslinin yapay zeka tarafındaki gerçek potansiyeli konusunda çok daha fazla test sonucu ortaya çıkacaktır.