⚡ Haberin Özeti
- Google’ın “Sleep” yöntemi, yapay zekâların öğrendiklerini kalıcılaştırmayı hedefliyor.
- Sistem, yeni bilgiler öğrenilirken eski yeteneklerin unutulmasını azaltmaya çalışıyor.
- Deneylerde 10 milyon tokenlık uzun bağlam ve sürekli öğrenmede güçlü sonuçlar elde edildi.
Google’da Konsol Köşesi’ni tercih edilen kaynak yap
Google araştırmacıları, büyük dil modellerinin en önemli sorunlarından biri olan sürekli öğrenme ve “yıkıcı unutma” problemine insan beyninden esinlenen sıra dışı bir çözüm geliştirdi. “Sleep” yani Uyku adı verilen yeni yaklaşımda yapay zekâ modeli, aktif çalışma dönemlerinin ardından öğrendiği bilgileri pekiştirmek ve yeteneklerini geliştirmek için ayrı bir “uyku” aşamasına geçiyor.
Ancak buradaki uyku kavramını gerçek anlamıyla düşünmemek gerekiyor. Yapay zekâ bilinçli biçimde uyumuyor veya rüya görmüyor. Google’ın kullandığı “uyku” ve “rüya” ifadeleri, modelin yeni girdiler almadığı ve bunun yerine hafıza pekiştirme ile kendi kendine eğitim süreçlerini yürüttüğü teknik aşamaları tanımlamak için kullanılıyor. Google Research, yöntemi 27 Ekim 2026 tarihinde ayrıntılı olarak tanıttı. Çalışmanın temelini oluşturan “Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories” başlıklı araştırma ise Haziran 2026’da yayımlandı.
Yapay zekâların en büyük sorunlarından biri: Öğrenirken unutmak
ChatGPT, Gemini ve Claude gibi günümüzün büyük dil modelleri, kendilerine sohbet sırasında verilen belgeleri ve bilgileri mevcut bağlam içerisinde kullanabiliyor. Ancak bu durum, modelin temel ağırlıklarının her sohbet sonrasında otomatik olarak güncellendiği anlamına gelmiyor.
Ürünlerde bulunan kullanıcı belleği gibi özellikler de modelin temel bilgi birikiminin yeniden eğitilmesinden farklı çalışıyor. Büyük dil modellerinin kalıcı biçimde yeni bilgi veya yetenek edinmesi için genellikle ek eğitim, sürekli ön eğitim ya da fine-tuning (ince ayar) gibi yöntemlere ihtiyaç duyuluyor.
Burada ise önemli bir problem ortaya çıkıyor: catastrophic forgetting, Türkçede yaygın kullanılan karşılığıyla yıkıcı unutma.
Bir sinir ağı yeni görevler üzerinde eğitildiğinde, yapılan parametre değişiklikleri daha önce öğrenilmiş bilgi ve becerilerin bir bölümünü bozabiliyor. Bu problem uzun yıllardır sürekli öğrenme araştırmalarının temel konularından biri. Google da daha önce farklı yöntemlerle yıkıcı unutmayı azaltmaya yönelik çalışmalar yürütmüştü.
Yeni Sleep yaklaşımı ise probleme farklı bir açıdan yaklaşıyor: Yapay zekânın sürekli olarak öğrenmeye çalışması yerine, öğrenme ve pekiştirme dönemlerini birbirinden ayırmak.
Google’ın yapay zekâ “uyku” sistemi nasıl çalışıyor?
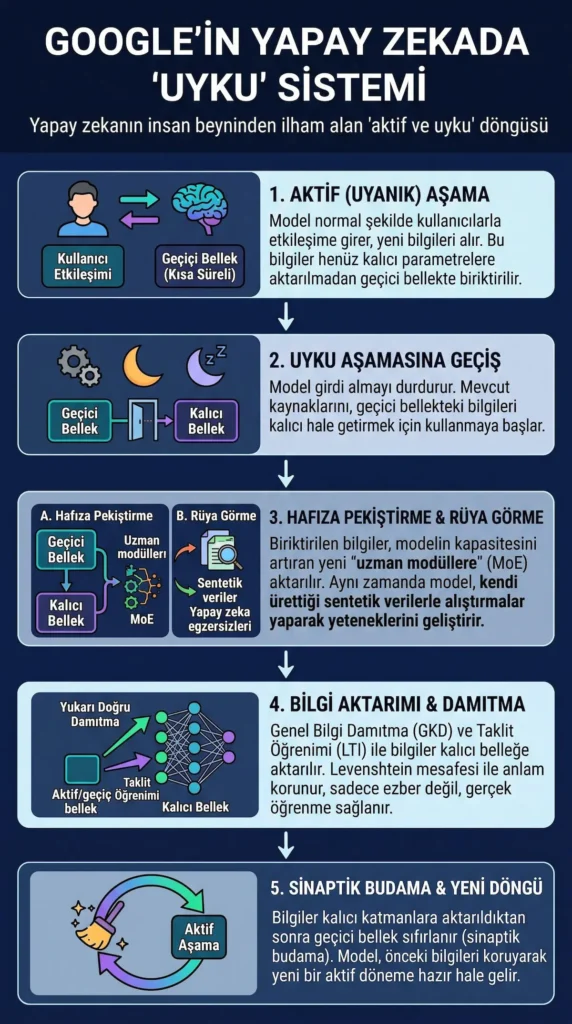
Google araştırmacılarının geliştirdiği yapı iki temel döneme ayrılıyor:
Aktif (wake) aşama: Model yeni girdiler alıyor, kullanıcılarla veya veri akışlarıyla etkileşime giriyor ve kısa süreli bilgileri hızlı çalışan bellek bileşenlerinde tutuyor.
Uyku (sleep) aşaması: Model yeni girdileri işlemeye ara veriyor. Hesaplama kapasitesi, kısa süreli bellekte bulunan bilgileri daha kalıcı hâle getirmek ve mevcut yetenekleri geliştirmek için kullanılıyor.
Bu fikir, insanların uyku sırasında yaşadığı hafıza pekiştirme süreçlerinden esinleniyor. Google araştırmacıları özellikle kısa süreli bilgilerin daha kalıcı yapılara aktarılması fikrini makine öğrenimine uyarlıyor.
Google’ın açıklamasına göre Sleep sisteminin uyku bölümü de kendi içerisinde iki temel sürece ayrılıyor: Memory Consolidation (hafıza pekiştirme) ve Dreaming (rüya görme).
Yapay zekânın hafızası yeni uzman modüllerle genişletiliyor
Yeni bilgi öğrenirken eski bilgilerin zarar görmesini engellemek için sistemin kapasitesi uyku aşamasında genişletiliyor.
Burada Mixture of Experts (MoE) mimarisinden yararlanılıyor.
MoE sistemlerinde tek bir dev ağın her sorguda bütünüyle çalıştırılması yerine farklı alanlarda uzmanlaşmış alt ağlar bulunuyor. Gelen girdiye bağlı olarak yalnızca gerekli uzmanların etkinleştirilmesi sayesinde model kapasitesi artırılırken hesaplama maliyetinin aynı oranda büyümesinin önüne geçilebiliyor.
Google’ın Sleep yaklaşımında ise uyku sırasında yeni düşük dereceli (low-rank) uzman bileşenleri kullanıma açılıyor. Böylelikle yeni bilgilerin doğrudan eski parametrelerin üzerine yazılması yerine, bunları taşıyabilecek ek kapasite oluşturulması amaçlanıyor.
Araştırmacılar bu sistemi, farklı güncellenme hızlarında çalışan bir bellek hiyerarşisinin parçası olarak değerlendiriyor.
Kısa süreli bilgiler uzun süreli belleğe aktarılıyor
Sistemin önemli bileşenlerinden biri Knowledge Seeding adı verilen süreç.
Google bunu “upward distillation”, yani kabaca yukarı doğru damıtma yaklaşımı olarak tanımlıyor. Aktif kullanım sırasında hızlı ve kısa süreli bellek katmanlarında biriken bilgiler, daha geniş ve daha kalıcı parametre yapılarına aktarılıyor.
Bu aktarım için Generalized Knowledge Distillation (GKD) ile pekiştirmeli öğrenmeye dayanan taklit öğrenimi yöntemleri bir arada kullanılıyor.
GKD’nin önemli özelliklerinden biri, öğrenci modelin yalnızca öğretmen model tarafından önceden oluşturulmuş örnekleri taklit etmemesi. Model kendi ürettiği çıktılar üzerinde de öğretmen modelden geri bildirim alabiliyor. Google DeepMind’ın daha önce yayımladığı GKD çalışması da yöntemin özetleme, çeviri ve matematiksel akıl yürütme gibi görevlerde kullanılabileceğini göstermişti.
Sleep sisteminde ayrıca Learning to Imitate (LTI) yaklaşımı kullanılıyor. Modelin ürettiği çıktılar, öğretmen modelin çıktılarıyla hem anlamsal benzerlik hem de metinsel benzerlik açısından değerlendiriliyor.
Burada kullanılan ölçütlerden biri de Levenshtein mesafesi. Bu metrik, bir metni diğerine dönüştürmek için gereken ekleme, silme veya değiştirme işlemlerinin sayısını ölçüyor.
Amaç yalnızca öğretmenin kullandığı kelimeleri birebir tekrar eden bir öğrenci oluşturmak değil; aktarılmak istenen anlamın korunmasını sağlamak.
Geçici bellek daha sonra temizleniyor
Bilgiler daha kalıcı parametrelere aktarıldıktan sonra sistem geçici bellekte kullanılan yüksek frekanslı parametreleri sıfırlayabiliyor.
Google bu aşamayı biyolojiden alınan bir başka terimle synaptic pruning, yani sinaptik budama olarak tanımlıyor.
Bunun amacı kısa süreli bellekte yeni bir aktif kullanım dönemi için alan açmak. Teoride model böylece önceki dönemlerde öğrendiği bilgileri uzun süreli yapılarında tutarken yeni verileri işlemeye devam edebiliyor.
Yapay zekânın “rüya görmesi” ne anlama geliyor?
Sleep sisteminin belki de en dikkat çekici tarafı Dreaming, yani rüya aşaması.
Burada modelin görevi yalnızca yeni bilgileri saklamak değil. Sistem aynı zamanda kendi kendine yeni eğitim örnekleri oluşturarak mevcut becerilerini geliştirmeye çalışıyor.
Normal kullanım sırasında MoE yönlendiricisi, girdiye en uygun uzmanları seçiyor. Rüya aşamasında ise sistem kasıtlı olarak farklı uzman kombinasyonlarını etkinleştirebiliyor.
Bu sayede normalde bir araya gelmeyebilecek bilgi alanlarının etkileşime girmesi ve modelin yeni bağlantılar keşfetmesi hedefleniyor.
Model daha sonra bu kombinasyonlardan hareketle sentetik eğitim örnekleri, araştırmacıların benzetmesiyle kendi “rüyalarını” oluşturuyor.
Fakat üretilen her veri doğrudan eğitimde kullanılmıyor.
Gradient-based data selection, yani gradyan tabanlı veri seçimi yöntemiyle modele en fazla katkıyı sağlaması beklenen örnekler seçiliyor. Ardından bu veriler üzerinde gözetimli ince ayar ve pekiştirmeli öğrenme uygulanabiliyor.
Sistem daha sonra yapılan değişikliklerin sonraki görevlerde gerçekten performans artışı sağlayıp sağlamadığını da değerlendiriyor.
10 milyon tokenlık testte dikkat çekici sonuç
Google araştırmacılarının paylaştığı deney sonuçları, Sleep yaklaşımının özellikle sürekli öğrenme ve uzun bağlam konusunda dikkat çekici performans gösterdiğine işaret ediyor.
Testlerden biri BABILong benchmark’ı üzerinde gerçekleştirildi.
BABILong, gerekli bilgilerin son derece uzun metinlerin farklı noktalarına dağıtıldığı ve modelin bu bilgiler arasında bağlantı kurmasının gerektiği bir değerlendirme sistemi. Benchmark’ın yayımlanan sürümleri 10 milyon tokena kadar uzunlukları destekliyor.
Google’ın aktardığı deneylerde Sleep yöntemi, 10 milyon token seviyesine kadar uzanan testlerde oldukça yüksek performans gösterdi ve araştırmacıların karşılaştırmasında GPT-4 ile Titans gibi yöntemlerin üzerinde sonuçlar elde etti. Burada önemli bir ayrıntı bulunuyor: Sistem 10 milyon tokenı klasik anlamda tek seferde dev bir bağlam penceresine yüklemek yerine, bilgiyi uyku sırasında parametre tabanlı belleğe pekiştirme yaklaşımından yararlanıyor.
Dolayısıyla sonuçları “Google 10 milyon tokenlık yeni sohbet penceresi geliştirdi” şeklinde yorumlamak doğru olmaz.
Mançu ve Kalamang dillerinde unutma büyük ölçüde engellendi
Araştırmanın bir başka deneyi ise sürekli çeviri üzerine gerçekleştirildi.
Google, modelin daha önce karşılaşmadığı veya eğitim verisinin sınırlı olduğu Mançu ve Kalamang gibi dilleri ardışık şekilde öğrenmesini test etti.
Araştırmacıların sonuçlarına göre Sleep yaklaşımı birden fazla öğrenme aşamasının ardından önceki görevlerde neredeyse sıfıra yakın performans kaybı gösterirken, geleneksel supervised fine-tuning, in-context learning ve bazı diğer karşılaştırma yöntemlerinde daha ciddi yıkıcı unutma görüldü.
Bu sonuç, yöntemin temel hedeflerinden biri olan “yeni bilgi öğrenirken eskisini koruma” konusunda önemli bir deneysel gösterge oluşturuyor.
SQuAD testinde yüzde 48,9 sonuç
Yeni olgusal bilgilerin kalıcı şekilde öğrenilmesini ölçen deneylerde de Sleep yaklaşımı mevcut karşılaştırma yöntemlerinin üzerinde sonuç verdi.
Google’ın açıkladığı verilere göre yöntem, SQuAD tabanlı tek görev değerlendirmesinde yüzde 48,9, sürekli ön eğitim değerlendirmesinde ise yüzde 46,2 sonuç elde etti.
Araştırmacılar bu değerlerin temel model, klasik supervised fine-tuning ve SEAL (Self-Adapting Language Models) gibi karşılaştırılan yöntemlerin üzerinde olduğunu belirtiyor.
Matematiksel akıl yürütme testlerinde de dikkat çekici sonuçlar bildirildi. Sleep ile geliştirilen temel model; AIME 2024, AIME 2025 ve HMMT 2025 değerlendirmelerinde sırasıyla yüzde 79,2, yüzde 69,0 ve yüzde 46,1 doğruluk elde etti.
Yapay zekâlar gerçekten kendi kendine öğrenmeye başlayabilir mi?
Sleep yaklaşımının asıl önemi, tek tek benchmark sonuçlarından daha geniş bir soruya dayanıyor.
Günümüzde büyük yapay zekâ modellerinin önemli bir bölümü temelde eğitim ve kullanım aşamalarının birbirinden ayrıldığı sistemler. Model devasa veri kümeleri üzerinde eğitiliyor, daha sonra kullanıma sunuluyor. Yeni bilgi geldiğinde modelin parametrelerini güvenli biçimde değiştirmek ise oldukça karmaşık bir süreç.
Google’ın önerdiği yapı başarılı şekilde ölçeklenebilirse bu ayrımın daha bulanık hâle gelmesi mümkün.
Gelecekte yapay zekâ sistemleri belirli süreler boyunca kullanıcılarla veya çevreleriyle etkileşim kurabilir, ardından çevrimdışı bir konsolidasyon aşamasına geçerek öğrendiklerini uzun süreli belleğe aktarabilir ve kendi oluşturdukları sentetik görevlerle yeteneklerini geliştirebilir.
Bu da modellerin yalnızca belirli aralıklarla dev eğitim süreçlerinden geçirilen statik sistemler yerine, zaman içerisinde kontrollü biçimde değişebilen sürekli öğrenen yapay zekâlara dönüşmesinin önünü açabilir.
Bununla birlikte Google’ın çalışması şimdilik bir araştırma yaklaşımı ve deneysel çerçeve niteliğinde. Şirket, bu sistemi Gemini’nin mevcut tüketici sürümlerine getirilen yeni bir özellik olarak duyurmuş değil. Araştırma sonuçlarının çok daha büyük üretim modellerinde aynı şekilde ölçeklenip ölçeklenmeyeceği, güvenlik açısından nasıl kontrol edileceği ve sürekli kendi kendini güncelleyen modellerin nasıl denetleneceği gibi önemli sorular da bulunuyor.
Google araştırmacıları ise Sleep paradigmasının statik yapay zekâ modellerinden sürekli öğrenebilen sistemlere geçiş için yeni bir yol sunabileceğini düşünüyor.
Kısacası Google’ın yeni çalışması, “yapay zekâlar artık gerçekten uyuyacak” anlamına gelmiyor. Ancak insan beynindeki uyanıklık, hafıza pekiştirme ve rüya süreçlerinden esinlenen öğrenme döngüsü, geleceğin yapay zekâlarının bugün kullandığımız modellerden çok daha dinamik biçimde öğrenmesinin önünü açabilir.