Yapay zeka modelleri artık yalnızca metin yazmak, kod üretmek veya görselleri analiz etmekle sınanmıyor. DrivingBench adlı yeni bir araştırmada dört gelişmiş yapay zeka modeli gerçek bir Toyota Corolla’nın direksiyon, gaz ve fren kontrolünü devraldı. Sonuçlar ise genel amaçlı yapay zekaların fiziksel dünyadaki görevlerde hâlâ ne kadar zorlanabildiğini açık şekilde ortaya koydu.
Gerçek bir otoparkta konilerle hazırlanan parkura çıkan GPT-6 Astra, Claude Fable 5.1, Grok 4.6 ve GPT-5.6 Sol arasında rotayı baştan sona tamamlayabilen yalnızca GPT-6 Astra oldu. Model, ilk denemesinde parkurun yüzde 49’una kadar ilerledikten sonra ikinci denemesinde 134,7 metrelik parkuru 5 dakika 22 saniyede tamamladı.
Yapay zekaya gerçek bir Toyota Corolla nasıl kullandırıldı?
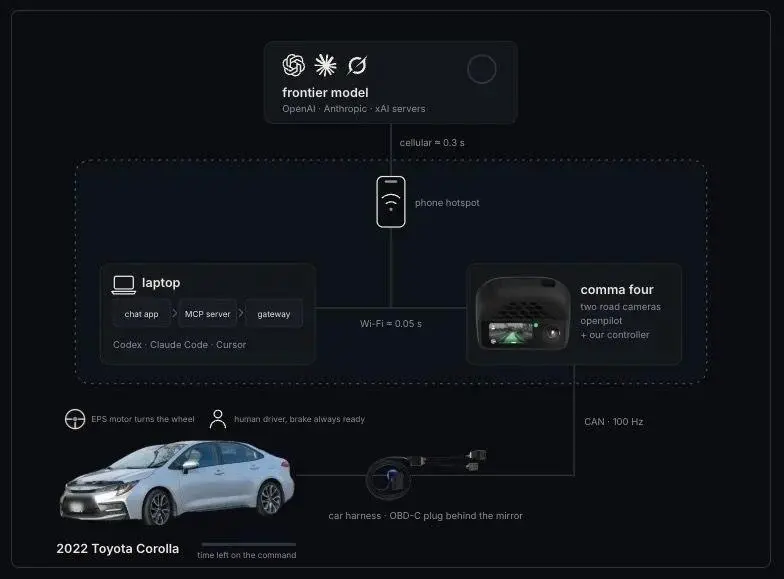
DrivingBench araştırmacıları deneyde 2022 model Toyota Corolla kullandı. Otomobile comma four cihazı bağlandı ve sistem, OBD-C bağlantısı üzerinden aracın CAN veri yoluyla iletişim kurdu. Kamera görüntüleri ve araç telemetrisi dizüstü bilgisayara aktarılırken yapay zeka modellerinin ürettiği sürüş komutları tekrar otomobile gönderildi.
Modeller doğrudan mekanik olarak direksiyonu çevirmek yerine sisteme yön, direksiyon yüzdesi, hız ve hareket süresini belirleyen komutlar verdi. openpilot altyapısı da bu komutları aracın direksiyon, hızlanma ve fren sistemlerinin anlayabileceği kontrol sinyallerine dönüştürdü.
Yapay zekalar ayrıca araç hareket halindeyken yeni kamera görüntülerini ve telemetri verilerini inceleyebildi. Böylece sistem yalnızca tek seferlik rota planlamak yerine gözlem yapma, karar verme, hareket etme ve hatalarını düzeltme döngüsü içerisinde çalıştı.
Parkur yapay zekaların algılama yeteneklerini zorladı
Deney için büyük bir otopark alanına küçük renkli koniler kullanılarak ters U şeklini andıran bir parkur hazırlandı.
Parkurda yapay zekaların sırasıyla bir sol dönüşü tamamlaması, uzun bir düzlüğü geçmesi, hafif virajları takip etmesi, iki sağ dönüş yapması ve son olarak mavi konilerle belirlenen bitiş alanına ulaşması gerekiyordu.
Bu görev ilk bakışta basit görünse de modeller açısından önemli bir problem ortaya çıktı: kamera görüntüsünden konilerin hangi tarafının yol sınırı olduğunu doğru anlamak.
Araştırmacıların analizine göre başarısız denemelerin önemli bölümü tam da bu aşamada yaşandı. Bazı modeller ilk virajdaki çapraz koni dizisini yanlış yorumladı ve parkurun yanlış tarafına yöneldi. Araştırma ayrıca kameranın aracın gerçek genişliği ve yakınındaki engeller konusunda modelleri yanıltabildiğini gösterdi.
GPT-6 Astra ikinci denemesinde parkuru tamamladı
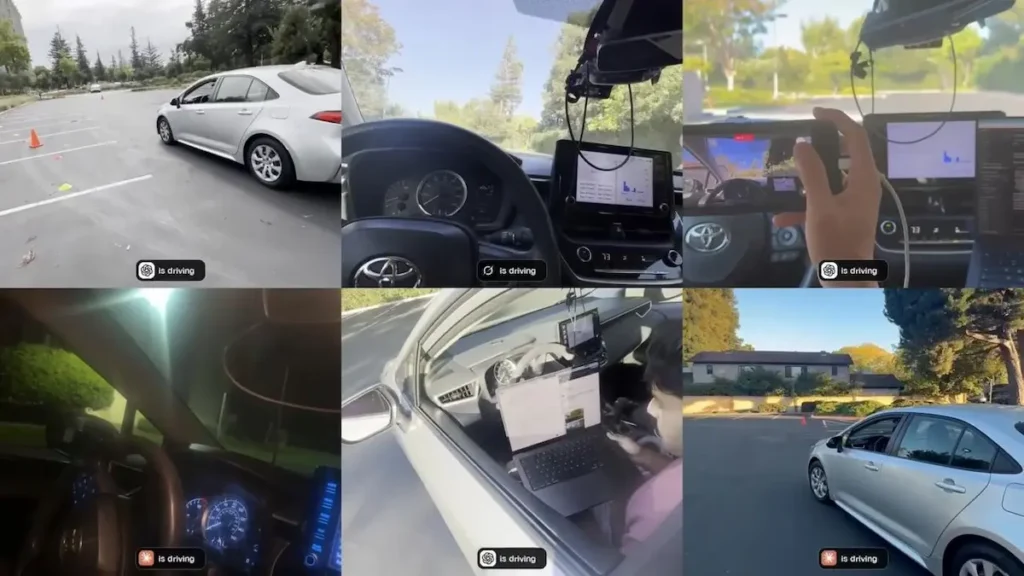
DrivingBench sonuçlarına göre GPT-6 Astra, ilk denemesinde rotanın yüzde 49’una kadar ilerledi ve 67,3 metre yol kat etti.
Model aynı konuşma bağlamını koruyarak yaptığı hataları analiz ettikten sonra ikinci kez parkura çıktı. Bu kez 134,7 metrelik rotanın tamamını geçerek yüzde 100 ilerleme kaydeden tek model oldu.
Tamamlanan sürüş 5 dakika 22 saniye sürdü ve sistem tarafından 24 hareket komutu kabul edildi.
Araştırmacılar Astra’nın ilk denemeden sonra özellikle virajlarda daha düşük hız kullanmaya ve direksiyon hareketlerini farklı şekilde yönetmeye başladığını belirtiyor. Bu değişiklik, aynı konuşma içerisinde önceki hatalardan yararlanabilen modellerin fiziksel görevlerde de belirli ölçüde bağlam içi öğrenme sergileyebileceğine işaret ediyor.
Claude, Grok ve GPT-5.6 Sol ne kadar ilerleyebildi?
Diğer üç model parkurun tamamını bitiremedi.
Claude Fable 5.1, ilk denemesinde yüzde 9, ikinci denemesinde yüzde 10 seviyesine ulaşırken üçüncü denemesinde önemli bir ilerleme göstererek parkurun yüzde 45’ini tamamladı.
Grok 4.6 için en yüksek sonuç yüzde 11 olurken model üç denemesinde sırasıyla yüzde 8, yüzde 11 ve yüzde 10 ilerleme kaydetti.
GPT-5.6 Sol ise üç denemenin tamamında yüzde 6 ilerleme seviyesinde kaldı.
Bu sonuçlar özellikle gerçek zamanlı fiziksel görevlerde yalnızca muhakeme kabiliyetinin yeterli olmadığını gösteriyor. Görüntüyü doğru yorumlamanın yanında gecikme süresi, sürekli gözlem ve yeterince hızlı yeni komut üretme de sürüş performansını doğrudan etkiliyor.
Yapay zekaların sorunlarından biri karar verme hızı oldu
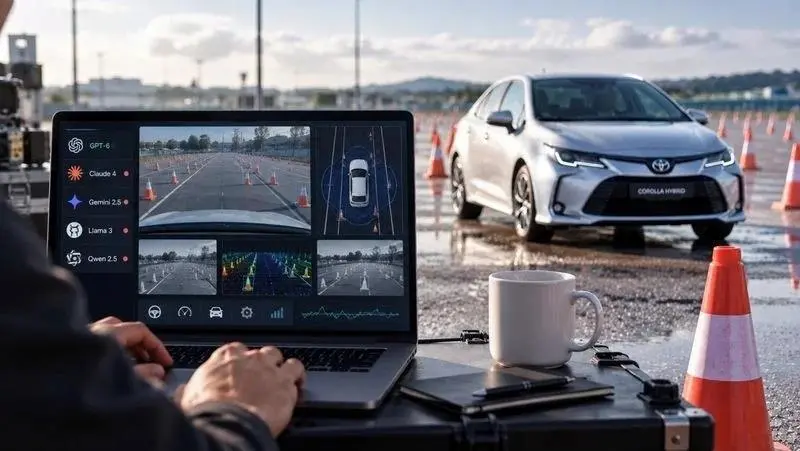
DrivingBench ekibinin dikkat çektiği en önemli konulardan biri modellerin düşünme süreleri arasındaki fark.
GPT-6 Astra’nın başarılı sürüşünde model yaklaşık 5-6 saniyede bir yeni gözlem gerçekleştirirken dakikada yaklaşık altı hareket komutu üretebildi.
Buna karşılık bazı modeller yeni karar üzerinde düşünürken araç uzun süre frenlenmiş şekilde bekledi. Örneğin Claude Fable 5.1’in ikinci denemesinde toplam 190 saniyelik süreç içerisinde otomobilin yalnızca 31 saniye hareket halinde kaldığı belirtiliyor.
Bu nedenle araştırmanın dikkat çeken sonuçlarından biri de fiziksel yapay zeka uygulamalarında modelin yalnızca doğru cevabı üretmesinin değil, doğru cevabı yeterince hızlı üretebilmesinin kritik olması.
Testlerde güvenlik önlemleri uygulandı
Deney, normal trafik koşullarında veya halka açık yollarda gerçekleştirilen bir otonom sürüş testi değildi.
DrivingBench yazılımında aracın istenen hızları 0,5 ile 3,5 m/s, yani yaklaşık 1,8 ile 12,6 km/sa arasında sınırlandırıldı. Ayrıca daha yüksek hızlarda hareketi iptal eden ek bir güvenlik mekanizması kullanıldı.
Testlerin tamamında otomobil içerisinde bir insan operatör bulunuyordu. Operatör, aracın parkur dışına çıkması veya bir engele yaklaşması durumunda hemen müdahale edebilmek için ayağını fren pedalının üzerinde hazır tuttu.
Araştırmacılar ayrıca sistemin Toyota, comma.ai, openpilot veya test edilen yapay zeka modellerinin üreticileri tarafından desteklenen ticari bir otonom sürüş ürünü olmadığını özellikle belirtiyor. DrivingBench bir araştırma ve değerlendirme çalışması olarak geliştirildi.
Sonuçlar otonom otomobiller için ne anlama geliyor?
GPT-6 Astra’nın gerçek bir otomobili kamera görüntüleri ve telemetri verilerinden yararlanarak konilerle oluşturulmuş bir parkur boyunca ilerletebilmesi dikkat çekici bir sonuç.
Ancak deney, genel amaçlı yapay zeka modellerinin bugünkü halleriyle şehir trafiğinde otomobil kullanmaya hazır olduğu anlamına gelmiyor.
DrivingBench son derece düşük hızlarda, kontrollü bir otoparkta ve gerektiğinde müdahale edebilecek bir güvenlik operatörü eşliğinde gerçekleştirildi. Ayrıca araştırmacılar her model için yalnızca bir test serisi uyguladı; aynı seri içindeki üç deneme de ortak konuşma geçmişini kullandığı için bağımsız deneyler olarak değerlendirilemiyor.
Buna rağmen çalışma, genel amaçlı yapay zeka modellerinin görüntü algılama, planlama, gerçek zamanlı karar verme ve fiziksel sistemleri kontrol etme yeteneklerinin birlikte ölçülebileceği dikkat çekici bir örnek sunuyor.
DrivingBench ekibi gelecek sürümlerde modelleri birden fazla bağımsız testte karşılaştırmayı, farklı muhakeme seviyelerini denemeyi ve daha uzun ya da daha zorlu parkurlar kullanmayı planlıyor.